Migração para Drupal 10: de Drupal 6 e 7
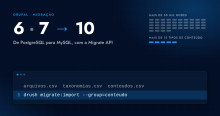
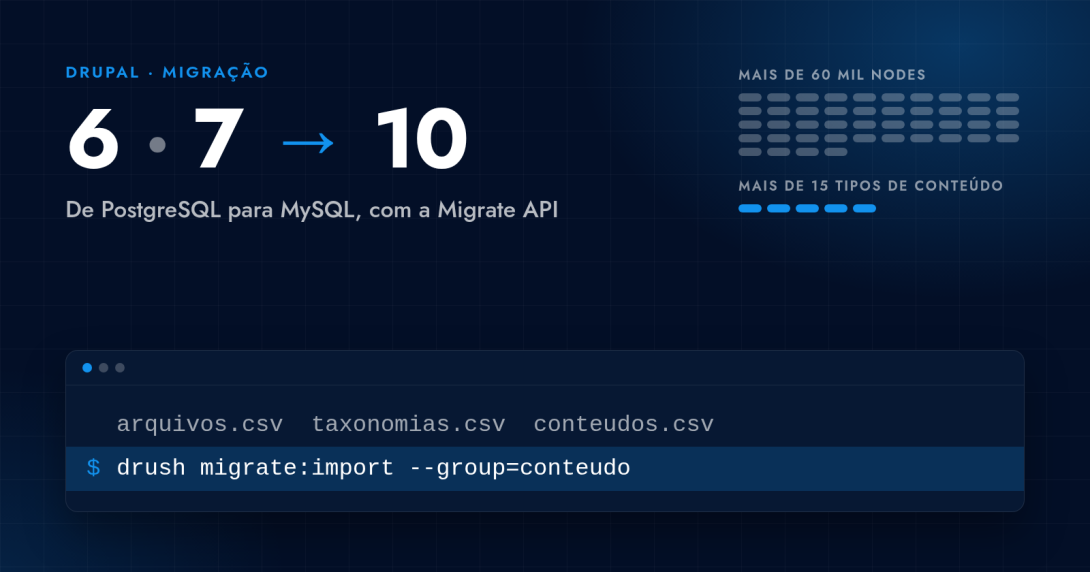
Sou Thalles Ferreira e liderei a migração para Drupal 10 de mais de 60 mil nodes, distribuídos em mais de 15 tipos de conteúdo. Os dados vinham de Drupal 6 e Drupal 7, ambos com PostgreSQL; o destino usava MySQL. A decisão que definiu o projeto foi exportar os dados para CSV e importá-los com a Migrate API, em vez de ler diretamente os bancos antigos.
Na época, fui o líder técnico responsável por toda a migração de conteúdo. Drupal 6 e Drupal 7 já não têm suporte oficial da comunidade; o suporte do Drupal 7 terminou em janeiro de 2025. Para quem mantém um site nessas versões, isso é um motivo concreto para planejar a saída. A experiência abaixo mostra como organizei o trabalho.
Por que escolhi CSV para a migração para Drupal 10
A migração Drupal-para-Drupal funciona bem quando a estrutura de origem pode ser mapeada para a estrutura de destino. Nesse projeto, o site novo era muito diferente. Os tipos de conteúdo do destino não espelhavam os antigos, então uma conversão automática um-para-um não servia.
Com CSV, pude separar a extração da importação. Também foi possível limpar e conferir os dados antes de carregá-los no destino. Isso tornou a transformação explícita: cada coluna exportada podia ser examinada e associada ao destino adequado. A Migrate API forneceu os plugins para ler as linhas, transformar valores e criar entidades no Drupal novo.
Usei os módulos Migrate, que faz parte do core, Migrate Plus, Migrate Tools, Migrate Source CSV, Migrate Conditions e Migrate Process Regex. A documentação da Migrate API explica os conceitos centrais; o projeto do Migrate Plus detalha os recursos adicionais do módulo. Na prática, cada regra de conversão ficava registrada, pronta para ser revisada e repetida.
Como organizei os grupos e a ordem das importações
Separei as migrações em três grupos e defini uma ordem baseada nas dependências: primeiro, arquivos e mídias; depois, taxonomias; por último, conteúdos. Assim, quando um conteúdo precisava apontar para uma entidade relacionada, ela já existia no destino.
Este exemplo é curto e usa nomes genéricos. Ele ilustra a leitura de um CSV, a conversão de data, a associação a um termo e o mapeamento de publicação:
id: noticias
migration_group: conteudo
source:
  plugin: csv
  path: 'private://migracao/noticias.csv'
  header_offset: 0
  ids: [id_antigo]
process:
  title: titulo
  created:
    plugin: format_date
    source: data_publicacao
    from_format: 'd/m/Y - H:i'
    to_format: U
  field_categoria:
    plugin: entity_lookup
    source: categoria
    entity_type: taxonomy_term
    bundle: categorias
    value_key: name
  status:
    plugin: static_map
    source: publicado
    map:
      Sim: 1
      Não: 0
  field_chave_migracao: id_antigo
destination:
  plugin: 'entity:node'
  default_bundle: noticia
O plugin que mais usei foi format_date. As datas chegavam como texto no formato brasileiro d/m/Y - H:i e precisavam virar timestamp ou data ISO. O segundo mais usado foi entity_lookup, para ligar conteúdos a termos e mídias já existentes. Também recorri a skip_on_empty, default_value, static_map, explode, callback com trim, concat, migration_lookup, make_unique_entity_field e machine_name. Cada um resolvia uma transformação específica, como separar vários valores de uma célula ou converter “Sim/Não” em publicado/despublicado.
Para acompanhar e executar grupos, os comandos do Migrate Tools eram:
drush migrate:status
drush migrate:import --group=<grupo>
drush migrate:rollback <migração>
As dificuldades: datas, arquivos e volume
A primeira dificuldade foram as datas e os formatos inconsistentes. Um campo podia chegar como texto, e valores diferentes exigiam tratamento antes da importação. Conferir a saída de cada conversão ajudava a manter datas válidas no destino.
A segunda foram os arquivos e as imagens. No Drupal novo, eles precisavam ser relacionados a entidades de mídia, não simplesmente tratados como nodes. Por isso, arquivos e mídias entravam antes dos conteúdos que apontavam para eles. Resolver essas referências exigia que os itens já estivessem disponíveis para consulta.
A terceira foi o volume e o tempo de execução. Um único tipo de conteúdo tinha mais de 30 mil nodes. Importar tudo em uma migração só consumia muita memória e deixava o processo muito lento. Dividi esse conteúdo em lotes de 5 mil nodes, cada um com sua própria migração, e isso deixou o processo mais rápido. Se um lote falhava, eu podia desfazer e reimportar só aquele lote.
Como validei os dados importados
A cada rodada, os conteúdos eram conferidos por amostragem. Quando algo não fechava, eu desfazia a importação com rollback, corrigia a migração e importava de novo. Assim, eu verificava os registros criados no destino e, se um lote apresentasse problema, podia desfazer e reimportar apenas aquele lote.
Também incluí em cada conteúdo um campo temporário com a chave do registro antigo. Ele permitia rastrear a origem quando uma amostra precisava ser investigada. Depois que a migração terminou e a conferência foi feita, removi esse campo temporário.
Manter as URLs também faz parte da migração
Preservei no site novo os mesmos endereços usados pelos conteúdos antigos. Isso importa porque links já publicados podem continuar apontando para aqueles endereços. Também ajuda os buscadores a reencontrar páginas conhecidas. A estrutura interna do site pode mudar; preservar URLs reduz a ruptura para quem chega por um link salvo ou por um resultado de busca.
O que eu faria igual de novo
Em outra migração para Drupal 10 com uma estrutura de destino diferente, eu manteria estas decisões práticas:
- Exportaria para CSV quando precisasse conferir e limpar dados antes de importar.
- Organizaria as migrações por dependência, importando arquivos, taxonomias e tipos de conteúdo nessa ordem.
- Dividiria em lotes de 5 mil nodes o tipo de conteúdo com mais de 30 mil, com uma migração por lote.
- Manteria uma chave temporária de origem para investigar registros durante a validação.
- Faria rodadas com amostragem, rollback, correção e nova importação quando os dados não fechassem.
Essa experiência está disponível hoje na MidiaUAI. Se você precisa decidir como sair do Drupal 6 ou 7, fale comigo.